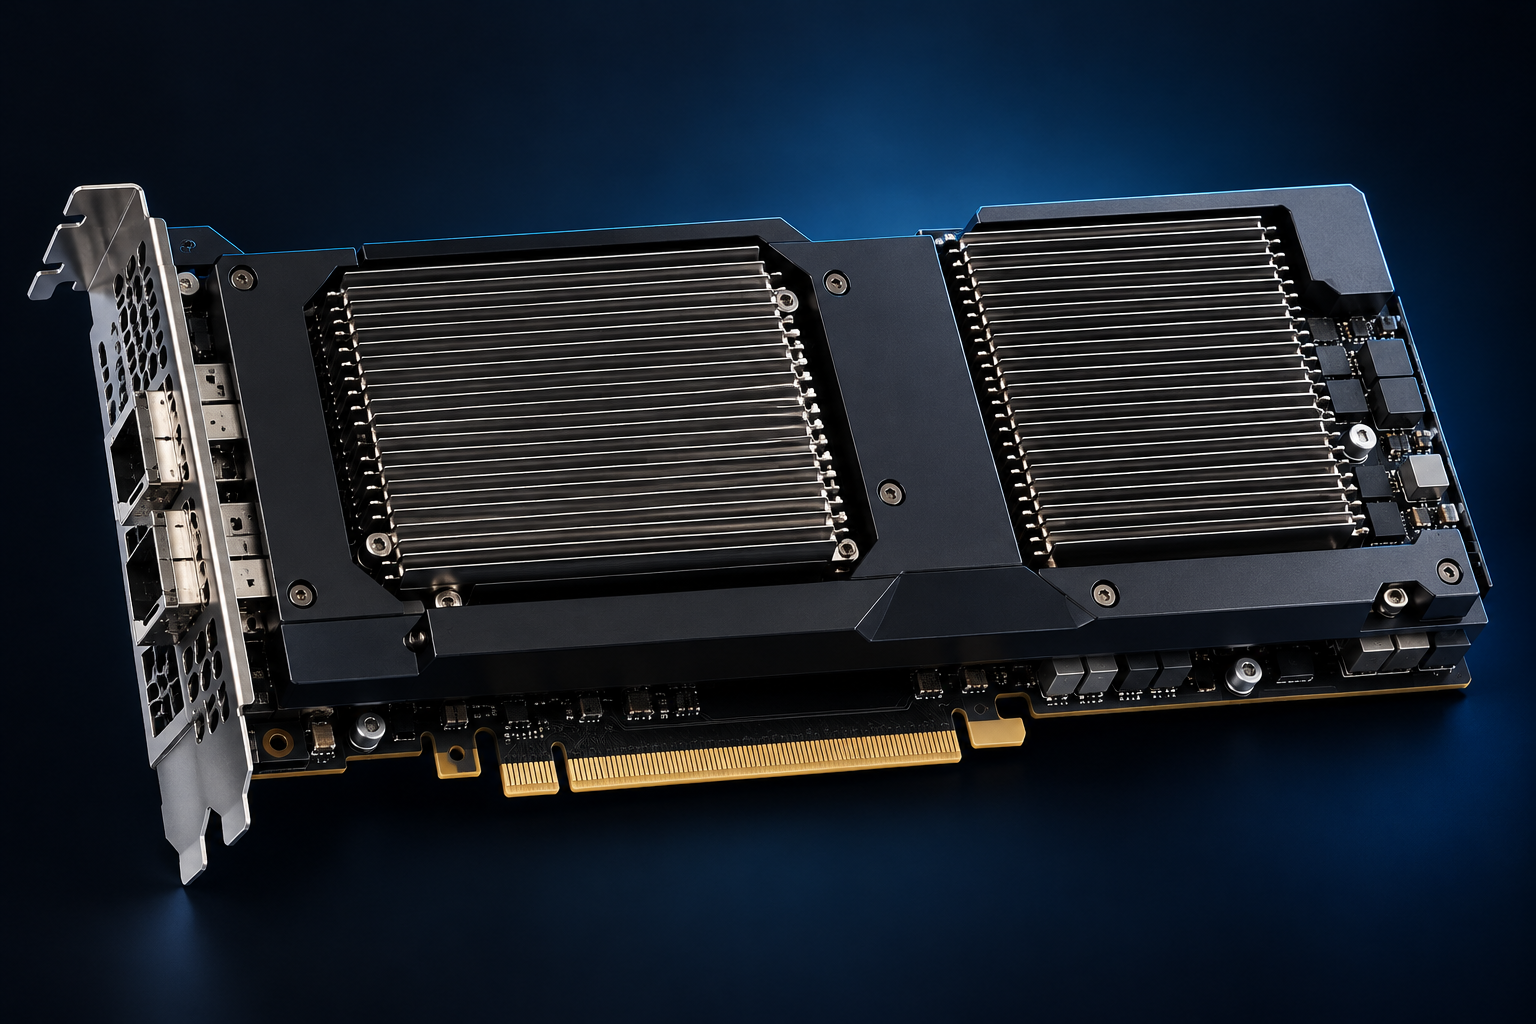
400G
AI 高速通信卡
面向大模型训练与推理集群,将通信数据面处理下沉到网卡侧,支持高带宽节点间互联。
- 2 × 200G 聚合 400G 网络接口
- RoCEv2 / RDMA 协议与数据面卸载
- 多路径、乱序处理与拥塞控制
PRODUCT STRATEGY
CMU DPU 管理算力资源与数据供给;CMU SuperNIC 处理集群高速通信。它们分别对应 AI 云和训练、推理集群的核心需求。

CMU 采用硬件直通架构,由芯片直接读取 SSD 数据,并通过 RDMA 跨网络传输至目标 GPU 服务器,减少 CPU 与软件层参与。
对端 CMU 可将数据直接写入 GPU HBM 指定位置,并与 vLLM、SGLang、LMCache 等推理框架协同,优化 KV Cache 跨节点加载链路。
SSD 数据由 CMU 直接读取,绕过 CPU 和软件层,缩短数据访问路径。
通过 RDMA 将数据跨网络直接传输到目标 GPU 服务器上的对端 CMU。
对端 CMU 接收数据后直接写入 GPU HBM 指定位置,减少中间拷贝与 CPU 开销。
通过内置插件与 vLLM、SGLang、LMCache 等推理框架交互。
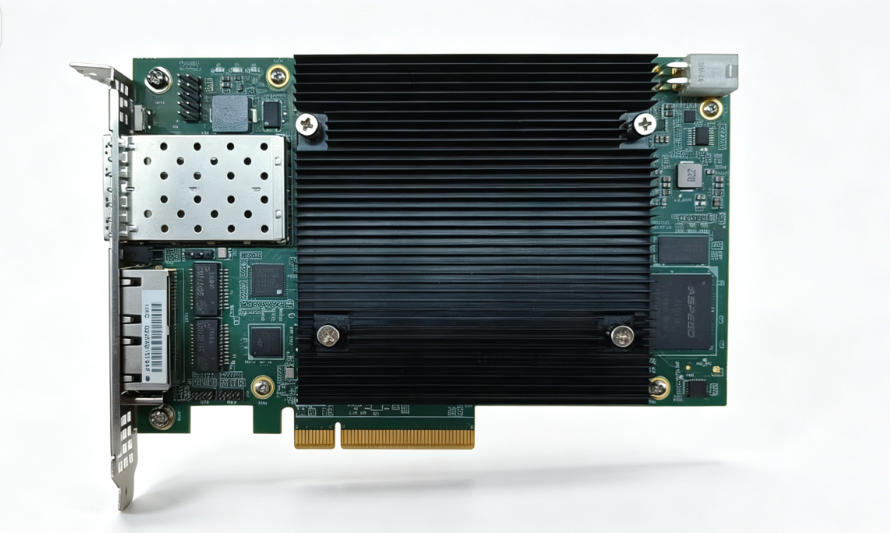
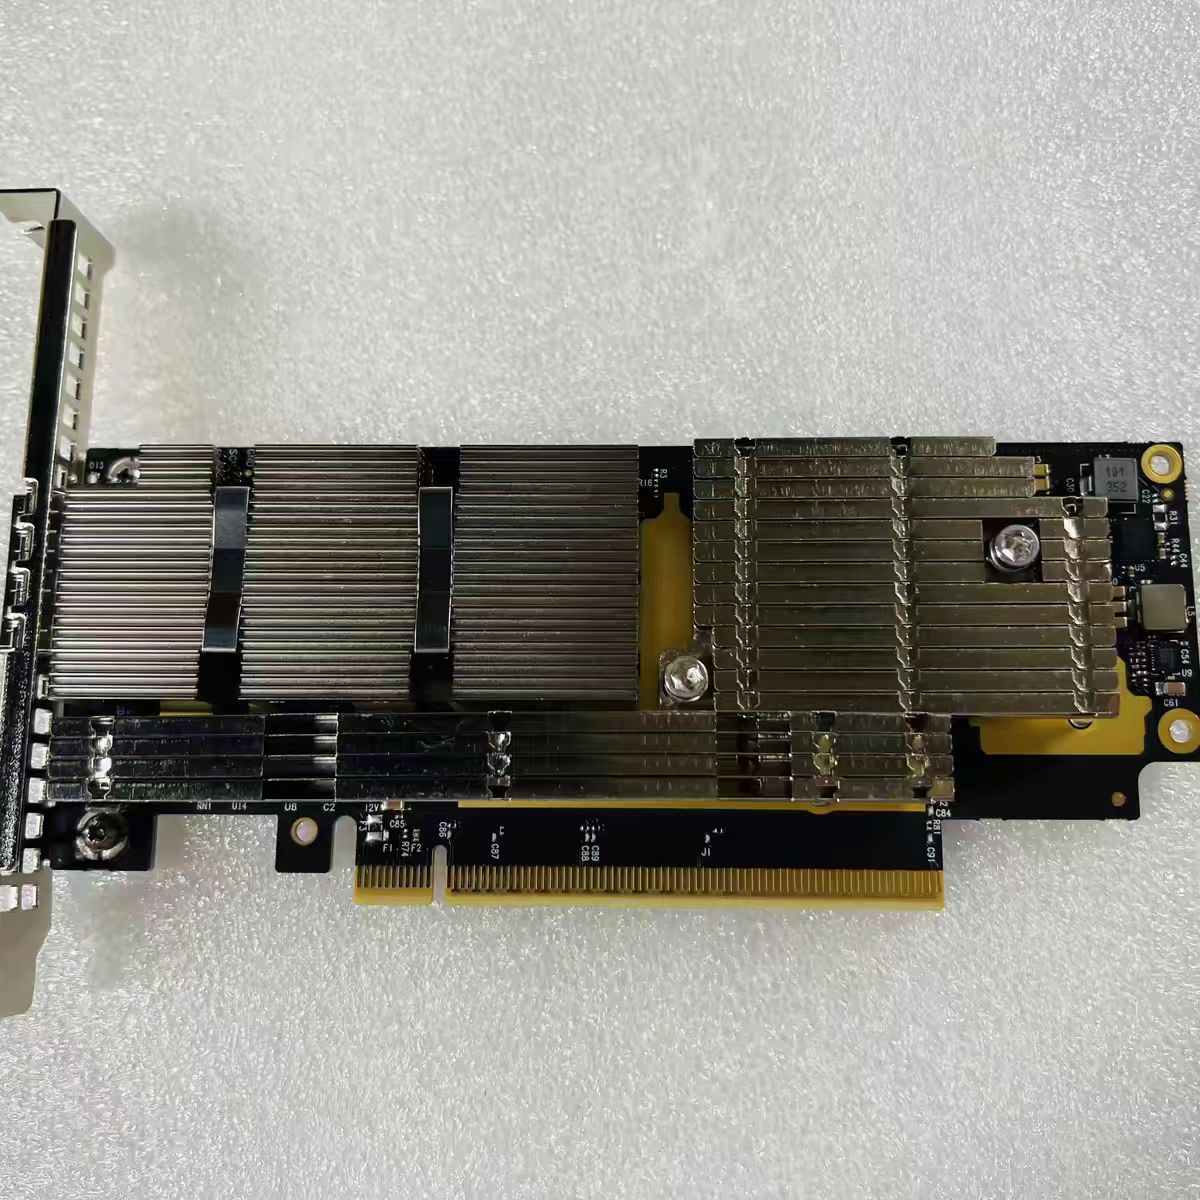
CMU SuperNIC 面向 AI 集群高速通信;CMU DPU 面向 AI 云和弹性裸金属的网络、存储与资源管理。
400G
面向大模型训练与推理集群,将通信数据面处理下沉到网卡侧,支持高带宽节点间互联。
400G
面向 AI 云与弹性裸金属,将网络、存储与管理能力从主机侧卸载,帮助 GPU 资源接入云平台。
第三代产品规划延续 SuperNIC 与 DPU 双产品形态,面向 800G AI 基础设施的通信与算力管理需求。
面向下一代训练与推理集群的高速互联产品,持续演进网络通信与数据面加速能力。
面向下一代 AI 云与弹性裸金属基础设施,持续演进网络、存储与资源管理能力。
第三代产品的规格、能力及交付节奏以实际研发验证和正式发布为准。